Nie każde ułatwienie jest dobrym projektem
Od kilku tygodni wraca do mnie jedno pytanie. Czy to, co uważamy za sukces w projektowaniu produktów AI, czyli usunięcie każdego możliwego tarcia, nie jest czasem błędem w założeniach.
To pytanie nie jest abstrakcyjne. Siedzi w każdym projekcie, w którym uczestniczę. Klient przychodzi z prośbą o to, żeby jego asystent AI był szybszy, bardziej płynny, żeby użytkownik nie musiał się nad niczym zastanawiać. I przez większość mojej kariery uczono mnie, że to jest właśnie dobry projekt. Mniej kliknięć. Mniej wysiłku. Mniej oporu.
Trzy teksty, które przeczytałam w ostatnim miesiącu, złożyły mi się w jedną całość i pokazały, dlaczego to założenie trzeba zrewidować.
Tarcie, które uczy
Zespół z University of Toronto i Yale, Zohar, Bloom i Inzlicht, opublikował w Communications Psychology krótki, ale bardzo precyzyjny tekst zatytułowany Against frictionless AI. Ich punkt wyjścia jest prosty. Ludzie od zawsze wybierają ścieżkę najmniejszego oporu, to jedna z najbardziej uniwersalnych zasad psychologii. A jednocześnie regularnie sami sobie ten opór fundujemy, bo bez niego nic nie ma dla nas wartości. Zjawisko to nazywa się paradoksem wysiłku.
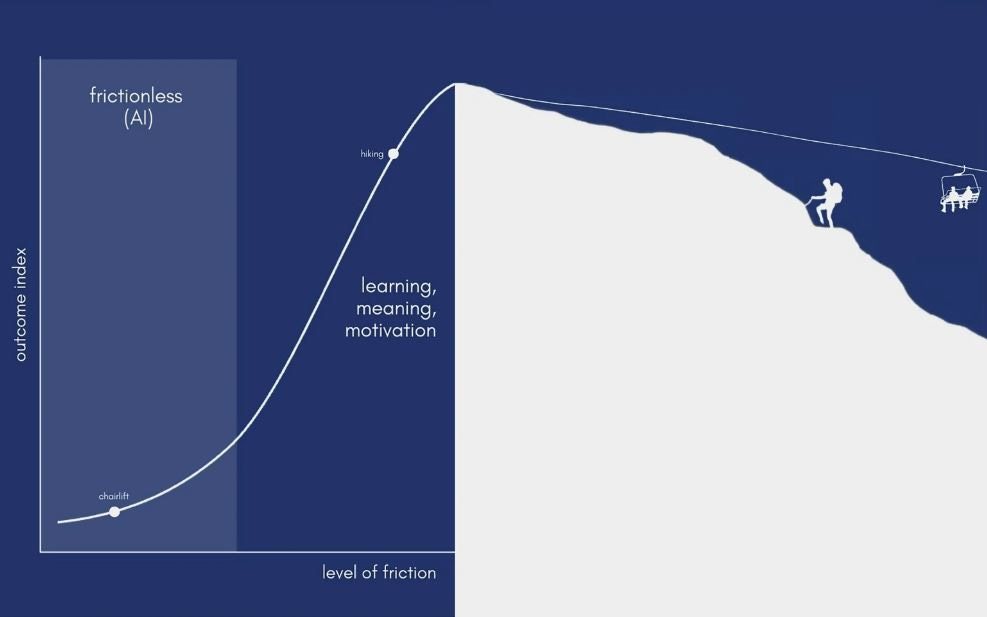
Autorzy piszą o czymś, co nazywają desirable difficulties, czyli pożądanych trudnościach. Zmaganie się z kodowaniem, przywoływaniem i reorganizacją informacji, niezależnie od tego, czy dzieje się to przez aktywne zaangażowanie, wytrwałość czy korektę, prowadzi do głębszego zrozumienia i trwalszego zapamiętywania. Kiedy AI usuwa ten wysiłek i podaje gotowe rozwiązanie, ten proces zostaje przerwany, zanim zdąży zadziałać. I rzeczywiście, są już dowody na to, że osoby korzystające z AI gorzej odtwarzają własną pracę, uczą się mniej i osiągają słabsze wyniki, gdy wsparcie AI zostaje odebrane.
To dotyczy nie tylko procesów poznawczych. Wysiłek bywa nieprzyjemny, ale to właśnie trud i zmaganie często nadają życiu sens. Kiedy pracujemy nad zadaniem, czujemy się bardziej kompetentni i wyżej cenimy efekt swojej pracy. Nawet jeśli zadanie jest obiektywnie pozbawione znaczenia, samo dodanie do niego tarcia zwiększa poczucie celu i sensu. To dlatego ludzie oceniają własny, niedoskonały tekst jako bardziej znaczący niż wygładzoną prozę napisaną przy pomocy ChatGPT, i domagają się za niego podobnej rekompensaty co za tekst dopracowany przez AI.
Autorzy są przy tym ostrożni. Nie postulują, żeby robić produkty trudniejsze na siłę, bo związek między wysiłkiem a sensem ma kształt odwróconej litery U. Zbyt mało tarcia odbiera nam korzyści, zbyt dużo przytłacza. Chodzi o umiejętność rozpoznania, które tarcie chroni użytkownika, a które tylko go frustruje.
Ekonomia zaufania
Drugi wątek, który uderzył mnie równie mocno, dotyczy tego, jak trudno nam rozpoznać moment, w którym coś idzie nie tak. Pat Pataranutaporn z MIT Media Lab, który bada, jak ludzie projektują swoje spersonalizowane AI, ujął to w rozmowie dla MIT News w sposób, którego nie zapomnę. “Często żartuję, że gdyby sztuczna inteligencja pojawiła się jak Terminator, o wiele łatwiej byłoby nam wiedzieć, co robić.” Prawdziwym wyzwaniem jest to, że sztuczna inteligencja często jawi się jako serdeczny przyjaciel, trener, nauczyciel czy towarzysz. To utrudnia rozpoznanie, że coś idzie nie tak.
W swoim badaniu Pataranutaporn i jego zespół pokazali, że ludzie projektujący własnego chatbota mylą się w przewidywaniu jego zachowania w 11 na 15 badanych cech, zwykle przeceniając cechy pozytywne i nie doceniając ryzyka, takiego jak nadmierna uległość modelu. Co ciekawsze, kiedy zespół dał użytkownikom narzędzie do wglądu w wewnętrzne reprezentacje modelu, zaufanie do systemu wzrosło, ale sposób projektowania chatbotów się nie zmienił. Sama przejrzystość nie wystarcza. To ważna lekcja dla każdego, kto myśli, że transparentność sama w sobie rozwiązuje problem zaufania.
Bo zaufanie do AI jest dziś rzadkim zasobem. Badanie KPMG i Uniwersytetu w Melbourne, obejmujące 47 krajów, pokazało, że mniej niż połowa ludzi ufa sztucznej inteligencji, a prawie dwie trzecie przyznaje, że polega na jej wynikach bez ich sprawdzania. Ta rozbieżność ma znaczenie, bo zaufanie zachowuje się jak kapitał. Buduje się powoli, a traci się natychmiast, i nie wraca po dawnej cenie. Deloitte musiał zwrócić część kosztów kontraktu rządowego w Australii po tym, jak w raporcie wspomaganym przez AI znaleziono zmyślone źródła.
Widać już, gdzie rodzi się nowy rynek strażników tego zaufania. Wielka Czwórka firm audytorskich wprowadza usługi zapewnienia bezpieczeństwa AI jako osobną linię biznesową, sprzedając prawo do stwierdzenia, że system został przetestowany. Ubezpieczyciele Lloyd’s of London zaczęli tworzyć polisy chroniące przed halucynacjami AI, w których modele są oceniane przed wystawieniem ubezpieczenia, a wypłata następuje, jeśli uzgodnione progi wydajności przestają być spełnione. Uniwersytety wracają do egzaminów pisanych ręcznie i nadzorowanych, bo esej napisany w domu przestał być dowodem czegokolwiek. Szwecja wydaje ponad sto milionów dolarów na przywrócenie drukowanych podręczników do szkół, a Norwegia ogłosiła niemal całkowity zakaz stosowania AI w szkołach podstawowych. Ekonomista Herbert Simon pisał o tym już w tysiąc dziewięćset siedemdziesiątym pierwszym roku, że bogactwo informacji prowadzi do ubóstwa uwagi. Różne instytucje reagują dziś w różny sposób, ale wszystkie wycofują się do systemów, którym można zaufać.
Skąd wiadomo, które tarcie zostawić
Te trzy wątki, badania nad pożądanymi trudnościami, ślepy punkt w projektowaniu AI i gorączkowe budowanie infrastruktury zaufania, prowadzą do tego samego pytania. Skoro nie chodzi o to, żeby usuwać każde tarcie ani żeby zostawiać je wszędzie, to jak konkretnie zdecydować, które tarcie w danym momencie interakcji zostawić, a które usunąć.
To pytanie stało u początku BehaviorAI Design Framework. Zbudowałam go jako trzypytaniową, bramkową metodologię, właśnie dlatego, że odpowiedź nigdy nie jest intuicyjna ani jednorazowa, tylko musi być powtarzalną decyzją projektową.
Pytanie pierwsze: diagnoza. Opiera się na modelu COM-B. Zanim zaprojektujemy jakąkolwiek interwencję, pytamy, czy użytkownikowi brakuje zdolności, okazji czy motywacji, żeby zachować się w pożądany sposób. W kontekście frictionless AI to pytanie brzmi inaczej niż zwykle. Nie pytamy, jak ułatwić użytkownikowi dotarcie do celu, tylko czy ułatwienie w tym konkretnym miejscu odbiera mu coś, czego rzeczywiście potrzebuje, na przykład możliwość nauczenia się czegoś albo zweryfikowania własnego osądu.
Diagnoza sama w sobie jest jednak zbyt ogólna, żeby przełożyć ją na konkretny projekt. Dlatego między diagnozą a interwencją wstawiłam drugą warstwę, którą nazywam FASCAI, czyli Fast and Slow Collaborative AI. To sposób nazwania trybu, w jakim człowiek i AI powinni współpracować w danym momencie, zapożyczony od Kahnemana i jego Systemów 1 i 2, rozszerzony o System 0.
System 0 to pełna automatyzacja, w której AI działa bez udziału człowieka. System 1 to szybka, intuicyjna współpraca, w której człowiek zachowuje kontrolę, ale nie musi świadomie przetwarzać każdego kroku. System 2 to wolna, refleksyjna współpraca, w której człowiek ma myśleć, weryfikować, budować własne zrozumienie.
Najprościej pokazać to na konkretnym przykładzie. Weźmy asystenta AI, który pomaga odpowiadać na e-maile. Kiedy użytkownik akceptuje sugerowaną odpowiedź na rutynowe potwierdzenie spotkania, to zadanie transakcyjne bez konsekwencji poznawczych, więc System 0 jest właściwym trybem i frictionless jest tu dobrą decyzją, nie błędem. Kiedy AI proponuje odpowiedź na wiadomość od ważnego klienta, w grę wchodzi ocena tonu i relacji, więc potrzebny jest System 1, czyli krótka pauza i możliwość korekty, zanim wiadomość wyjdzie. Kiedy AI ma pomóc napisać odpowiedź w sprawie spornej, na przykład reklamacji albo negocjacji warunków, stawka i konsekwencje są wysokie, więc potrzebny jest System 2, czyli własny szkic użytkownika przed pokazaniem wersji AI, żeby nie stracił własnego osądu w sprawie, w której on jeden ponosi odpowiedzialność.
Błąd, przed którym ostrzegają Zohar, Bloom i Inzlicht, polega właśnie na tym, że produkty domyślnie ześlizgują się do Systemu 0 wszędzie, bo jest tańszy w projektowaniu i lepiej wypada w testach użyteczności, nawet w miejscach, które powinny zostać w Systemie 1 albo 2.
Pytanie drugie: interwencja. Kiedy wiemy już, jaki tryb FASCAI powinien działać w danym momencie, korzystamy z Behaviour Change Wheel razem z biblioteką wzorców BehaviorAI, żeby zaprojektować konkretne rozwiązanie. Dla Systemu 1 to wzorzec pauzy przed zaakceptowaniem sugestii AI albo widoczny poziom pewności systemu zamiast gotowej odpowiedzi podanej jako fakt. Dla Systemu 2 to wzorzec, który prosi użytkownika o samodzielne sformułowanie wniosku, zanim pokażemy mu odpowiedź modelu. To są konkretne narzędzia odpowiadające na dokładnie ten problem, o którym piszą autorzy tekstu o desirable difficulties.
Pytanie trzecie: etyka. Domyka cały proces. Nawet jeśli wiemy, jak zaprojektować interwencję, pytamy, czy mamy prawo to zrobić i czyim interesom to służy. To pytanie chroni przed sytuacją, w której intencja obniżenia tarcia po drodze zamienia się w manipulację albo w projektowanie zależności, o której ostrzega Pataranutaporn, mówiąc o modelu, który stale afirmuje użytkownika zamiast go czasem skorygować.
Ten framework nie daje gotowej odpowiedzi na pytanie, ile tarcia jest właściwe. Nikt jej dziś nie ma, bo to zależy od kontekstu, etapu życia użytkownika i stawki decyzji. Ale daje strukturę, która nie pozwala pominąć pytania, zanim wdroży się kolejne ułatwienie, i pozwala tę samą interakcję zdiagnozować, nazwać jej właściwy tryb i przypisać jej konkretny wzorzec, zamiast rozstrzygać o tarciu intuicyjnie za każdym razem od nowa.
Właśnie tę warstwę, między tym, co AI potrafi zrobić, a tym, co powinno zrobić dla konkretnego użytkownika w konkretnym momencie, projektuję od lat. Dopiero teraz nauka zaczyna nazywać ją po imieniu.
Jeśli pracujesz nad produktem, w którym AI odpowiada za kluczowe decyzje użytkownika, chętnie pokażę, jak wygląda pełna wersja frameworku i biblioteki wzorców. Link w komentarzu.
Źródła
- Zohar, Bloom, Inzlicht — Against frictionless AI, Communications Psychology, 2026 https://www.nature.com/articles/s44271-026-00402-1
- Pat Pataranutaporn (MIT Media Lab), wywiad — 3 Questions: Neural transparency and the future of AI design, MIT News, lipiec 2026 https://news.mit.edu/2026/3-questions-neural-transparency-and-future-of-ai-design-0715
- Observer — artykuł o zaufaniu do AI i ekonomii władzy/osądu, lipiec 2026 https://observer.com/2026/07/future-ai-power-judgment-trust/
- KPMG i Uniwersytet w Melbourne — badanie o zaufaniu do AI w 47 krajach https://kpmg.com/xx/en/media/press-releases/2025/04/trust-of-ai-remains-a-critical-challenge.html
- Deloitte — zwrot części kosztów kontraktu rządowego w Australii po wykryciu zmyślonych źródeł w raporcie wspomaganym AI https://fortune.com/2025/10/07/deloitte-ai-australia-government-report-hallucinations-technology-290000-refund/
- Wielka Czwórka — wprowadzenie usług AI assurance jako linii biznesowej https://thefinancestory.com/big-4-to-launch-ai-assurance-services
- Lloyd’s of London — polisy ubezpieczeniowe od halucynacji AI https://www.armilla.ai/resources/insurers-launch-cover-for-losses-caused-by-ai-chatbot-errors
Widzisz to u siebie w firmie?
Opowiedz, co wdrożyliście i co nie działa tak, jak miało. Na krótkiej rozmowie wspólnie znajdziemy pierwszy krok.